AI 音樂製作 / 白盒符號樂譜 / LITAS
YuE2 多曲目組曲與 KYV 伴奏實踐
挑戰 7 首金曲熔接,打造母帶純伴奏與 KYV 練唱生態。
挑戰「多曲目混合」組曲工作流,剖析從 MiniMax 黑盒抽卡到 YuE2 白盒樂譜的演進。在端對端人聲難以匹配的技術現實下,轉向產出 48kHz 母帶純伴奏、毫秒級 KYV 變色字幕影片與互動網頁練唱工具,實現父親親口錄唱。
THE CASE IN A MINUTE
先看重點,再看細節。
- 01 要解決的問題
- 從單曲 Cover 走向 7 首經典組曲,黑盒難以調控跨曲轉調;而 AI 端對端直出人聲容易產生金屬感恐怖谷與情感缺失。
- 02 我的實作方式
- 以白盒 ABC 樂譜鎖定旋律骨架,漂亮轉向產出 48kHz 母帶純伴奏、過門呼吸空間與毫秒級 KYV 變色影片,由父親親口演唱。
- 03 做到的成果
- 完成《每一首都是妳》完整純伴奏專包、HTML 互動練唱工具與 YouTube KYV 示範,建立自主錄唱實戰手冊。
成果範圍包含受保護歌曲之改編練唱與純伴奏工程,非商用串流發行;示範影片發布於 YouTube 尚恩說故事頻道。
WATCH THE SOURCE
來源影片:尚恩說故事 的介紹
《每一首都是妳》7 首組曲完整純伴奏・KYV 逐字練唱版
創作者:尚恩說故事 · 發布於
全曲 7 首經典歌曲無縫熔接,搭配 48kHz 母帶級純伴奏與毫秒級動態變色字幕,專為在家練唱與錄音設計。
到 YouTube 觀看WORKFLOW AT A GLANCE
- 017 首旋律轉譜→
- 02跨曲調性銜接→
- 0348kHz 純伴奏渲染→
- 04KYV 字幕對齊→
- 05父親自主錄唱
現成模型應用與個人創作紀錄|包含受保護歌曲之改編練唱與純伴奏工程,非商用串流發行|示範影片已上傳 YouTube 尚恩說故事頻道
完整故事|YuE2 音樂生成實戰:挑戰「多曲目混合」組曲工作流,從無法直出人聲到完整純伴奏與 KYV 練唱系統的個人落地
過去兩年,AI 音樂生成給大眾的普遍印象是「提示詞抽卡」:在 Suno 或 Udio 的對話框裡輸入風格標籤、貼上歌詞,按下生成,然後像開盲盒一樣祈禱模型吐出好聽的旋律。
在上一篇 MiniMax Music 3 實作:給孩子一首歌,也替遊戲留下片尾曲 中,我曾記錄了為剛滿月的小朋友創作《凌晨三點的我們》的過程。那時我們透過本機 ComfyUI 搭配 MiniMax-Music 3,以文字提示詞與歌詞端對端生成出一首兩分鐘的溫暖歌曲。但那一輪實作也留下了非常深刻的體會:黑盒生成「第一版先留好,越改反而越偏」——只要想微調某句歌詞或修整和弦,重新輸入就會得到完全不同的演繹;伴奏與人聲黏在一起,旋律稍有走樣也無從修改。
如果你的目標稍微具體一點——例如想要「翻唱」經典作品(把童年回憶《Butterfly》換成抒情爵士、把流行歌的主旋律重新編曲、或是保留原曲旋律但改填新詞)——商業平台的限制就會立刻浮現:
- 版權關鍵字封鎖:平台為了避規,往往禁止上傳或直接封鎖已知歌曲名;
- 黑盒無法控譜:你無法告訴模型「請嚴格維持第 1 到第 8 小節的音高走向,只更換伴奏與歌手聲線」;
- 伴奏與人聲死結:生成出來的音訊是一個混音成品,旋律稍微走樣你也無從修改,只能消耗點數重新抽卡。
網路上以「開源翻唱音樂模型 YuE2:你的專業程度=模型上限,沒有 Suno 的各種限制。演示《Butterfly》」為題的展示,精準擊中了音樂創作者的痛點,證明了透過開源模型 YuE2 搭配符號樂譜鏈(ABC 譜)進行「白盒翻唱」的可行性。
然而,當我們真正把這套工具放進真實創作中時,如果只做一首單曲的翻唱,其實只發揮了這套技術最表面的一層能力。
在這篇文章中,我將以自己正在實踐的音樂生成工作流——家庭金曲組曲《每一首都是妳》為核心案例,分享如何從「單曲 Cover」跨越到難度極高的「多曲目混合(Medley 組曲)」,回顧從 MiniMax Music 3 走到 YuE2 的認知躍遷,以及在面對「AI 人聲無法完美匹配」的技術現實時,工作流如何漂亮轉向,產出廣播母帶級純伴奏、毫秒級 KYV(KTV 逐字練唱)變色影片與互動練習工具,並總結爸爸在家自主錄唱的個人實戰經驗。
本文示範影片:上傳 YouTube 的《每一首都是妳》KYV 逐字練唱版
這篇文章的核心示範,不再是單純的網路開源範例,而是直接採用我本次工作流實際產出並已上傳發布至 YouTube 【尚恩說故事】 頻道的 《每一首都是妳》7 首組曲完整純伴奏・KYV 逐字練唱版 作為導覽主體。

📺 YouTube 成果預覽與資訊卡: - 影片標題:
《每一首都是妳》7 首組曲完整純伴奏・KYV 逐字練唱版(48kHz 母帶級/伴唱用)- 發布頻道:尚恩說故事 - 線上播放:👉 點此在 YouTube 觀看全曲 KYV 示範影片 - 規格亮點:48 kHz / 24-bit 廣播母帶音質 | 毫秒級 KTV 變色字幕 | 預留 2~3 秒自然過門換氣 - 本機工程產物:V24_逐字練唱全曲.mp4 | 打開逐字練唱.html
全曲 7 首章節時間軸(可於 YouTube 說明欄或本機播放器直接跳轉對照):
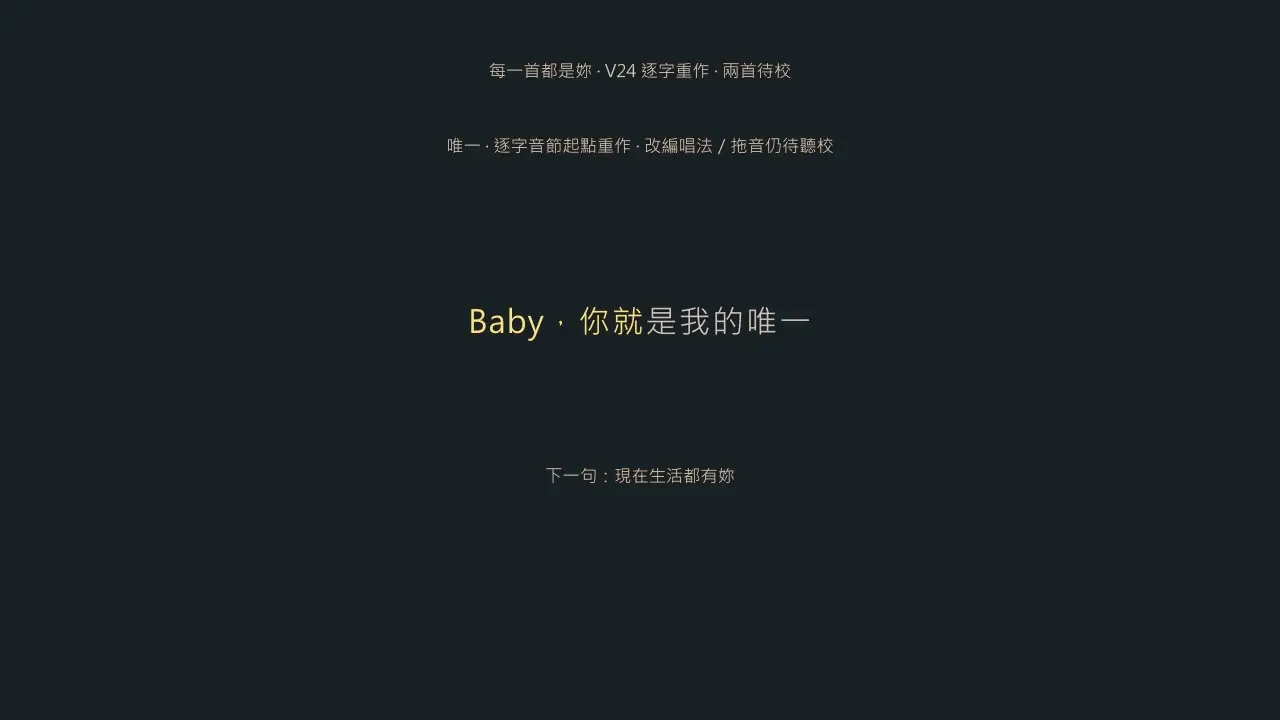
00:00前奏(木吉他溫暖鋪陳)00:02〈唯一〉:Baby,你就是我的唯一…想作首歌給妳00:16〈Baby Song〉:你的眼睛像顆水晶通透…和媽媽求婚時作的承諾00:58〈A Whole New World〉:I can show you the world…以後我們要一起去玩01:14〈寶貝〉:我的寶貝寶貝…拍嗝時別皺著臉,抽油煙機前哄睡01:48〈A Thousand Years〉:I have died every day…爸媽都累了,快要凌晨兩點02:07〈約定〉:終於睡了,現在只怕會落地醒…我會好好的愛妳02:32〈What a Wonderful World〉:妳又醒了,我抱起妳,今夜已經三點,What a wonderful world
這支影片展示了工作流如何將 7 首經典歌曲無縫熔接為 2 分 56 秒的溫暖組曲,並以毫秒級動態字幕(字到音節起點整字變色發光)為歌唱者提供清晰的進唱與呼吸導引。
從《凌晨三點的我們》到《每一首都是妳》:從黑盒抽卡到白盒組曲的演進
理解這次 YuE2 工作流的意義,最好的參照物正是之前發布的 MiniMax Music 3 實作:給孩子一首歌,也替遊戲留下片尾曲。
這兩次實作並非互相獨立的孤島,而是同一個創作者在面對「如何用音樂留下家庭記憶」這道題目時,技術路徑的深度進化:
graph LR
    A[第一階段: MiniMax Music 3<br/>《凌晨三點的我們》] -->|遭遇黑盒瓶頸: 越改越偏、伴奏人聲死結| B[第二階段: YuE2 符號樂譜鏈<br/>《每一首都是妳》]
    B --> C[白盒樂譜規劃: ABC 格式精確控音]
    B --> D[突破單曲: 7 首金曲跨調跨拍熔接]
    B --> E[漂亮轉向: 48kHz 純伴奏 + KYV 系統]
    E --> F[終點: 爸爸親口唱出真誠體溫]
1. 情感脈絡的深化:從深夜切片到 24 小時生活史詩
在 MiniMax 製作《凌晨三點的我們》時,起點非常具體:兩個人在夜裡輪流抱孩子、餵奶、拍嗝的疲憊與默契。那是一首兩分鐘的片段式抒情。
到了《每一首都是妳》,我希望將這段時光記錄得更加完整。它不再只是一首歌,而是一份涵蓋一整天生活的金曲組曲:從白天的凝視與未來承諾(〈唯一〉、〈Baby Song〉、〈A Whole New World〉),唱到夜晚真實手忙腳亂的抽油煙機哄睡(〈寶貝〉),再推進至午夜十二點、凌晨兩點的疲倦相依(〈A Thousand Years〉),直到凌晨三點落地醒後無怨無悔的抱起(〈約定〉、〈What a Wonderful World〉)。
2. 兩代音樂工具的本質對比:黑盒抽卡 vs 白盒控譜
| 比較維度 | 第一階段:MiniMax Music 3(《凌晨三點的我們》) | 第二階段:YuE2 組曲工作流(《每一首都是妳》) |
|---|---|---|
| 技術架構 | 端對端擴散/音訊 Token 預測(黑盒子) | AR-NAR 混合 Transformer + 符號樂譜鏈 CoT(白盒子) |
| 創作形式 | 單曲創作(約 2 分鐘原創) | 7 首經典金曲跨曲融合(2 分 56 秒組曲 Medley) |
| 旋律控制力 | 僅能靠文字 Prompt 描述情緒,無法精確指定音高 | 顯式 ABC 記譜法,可逐小節微調音符、和弦、休止符 |
| 修改迭代 | 「越改越偏」,改動一個字整首旋律面目全非 | 樂譜骨架文字化鎖定,可進行手術式局部微調 |
| 伴奏與人聲 | 伴奏與人聲綁死在同一個混音音訊中 | 伴奏與旋律骨架解耦,可單獨輸出 48kHz 純伴奏 |
| 演唱者歸屬 | AI 虛擬歌手代唱,無真實父親呼吸 | 放棄機器假音,轉向純伴奏 + KYV,由父親親口演唱 |
這場演進清楚表明:AI 音樂工具的進步,不是看它能不能一鍵生成更華麗的展示品,而是看它能否給予創作者更多的精確控制權。
為什麼 YuE2 能做到「真翻唱」?白盒符號規劃 vs 黑盒音波擴散
要理解這套工作流的根基,得先釐清兩條技術路線的分野。
YuE2 是由 Multimodal Art Projection(M.A.P.)於 2026 年 9 月開源的 30 億參數(3B)音樂模型。
其核心哲學是:「Compose in symbols. Create in sound.」(在符號中作曲,在聲音中創造)。在推論 API 中,cot="melody" 是改編與翻唱的靈魂所在——使用者直接提供主旋律譜(ABC 格式),模型只負責依照風格生成全新伴奏與人聲演繹。
graph TD
    A[原曲錄音 Audio: 例如 Butterfly.wav] --> B[音訊轉譜工具: SheetSage2 + MERT2]
    B --> C[生成純旋律譜: score.abc]
    C --> D{人工檢視與校對<br/>修正節奏、錯音、歌詞對位}
    D --> E[YuE2 推論引擎<br/>設定 cot='melody']
    F[新風格 Prompt / 新歌詞] --> E
    E --> G[48kHz 立體聲全新翻唱音訊]
然而,官方流程僅停留在「單曲 Cover」。當我們把這套流程投入到真實生活場景時,真正的挑戰才剛開始。
突破單曲思維:讚揚「多曲目混合」的高維命題與挑戰
在這次的實際創作中,我沒有選擇簡單地「把某一首老歌重唱一次」,而是給工作流提出了一個極具野心、也極具挑戰性的高難度命題:多曲目混合(Medley 組曲)。
1. 命題深度:7 首金曲熔接的一體化父愛敘事
這首名為《每一首都是妳》的作品,不是隨機切碎的歌單串燒,而是一段以「爸爸唱給兩個月大女兒小朵」為核心的生活史詩。它嚴格固定了 7 首橫跨數十年的經典旋律,並在保留原作靈魂 Hook 的同時,無縫接續已核准的改編新詞:
- 王力宏〈唯一〉:白天生活的開始,「Baby,妳就是我的唯一…想作首歌給妳」;
- 陳奕迅〈Baby Song〉:凝視女兒清澈的眼睛,「和媽媽求婚時作的承諾」;
- 迪士尼〈A Whole New World〉:對未來冒險的憧憬,「以後我們要一起去玩,但現在不行」;
- 張懸〈寶貝〉:真實接地氣的育兒夜晚,「拍嗝時別皺著臉…站在抽油煙機前轟隆隆哄妳入睡」;
- Christina Perri〈A Thousand Years〉:時間流轉至午夜,「爸媽都累了,現在快要凌晨兩點」;
- 周蕙〈約定〉:小心翼翼的呵護,「終於睡了,現在只怕會落地醒…」;
- Louis Armstrong〈What a Wonderful World〉:爵士收尾的滿足與釋懷,「妳又醒了,我抱起妳,今夜已經三點,What a wonderful world」。
2. 為什麼「多曲目混合」是測試 AI 音樂的終極試金石?
把 7 首歌串成一首順暢的音樂,難度是單曲翻唱的指數級倍數:
- 調性轉換(Modulation):7 首原曲的調性天差地遠(從降 E、C、G 到 D 調),硬接會產生刺耳的走音,必須規劃自然的轉調和弦;
- 拍號與節奏重組(BPM / Meter):從 4/4 抒情拍、6/8 搖籃律動到爵士三連音,如何讓整首曲子聽起來像同一個樂團在現場演奏?
- 旋律 Hook 保真與字音對位:改編詞的中文聲調必須緊貼原旋律,不能發生「倒字」;
- 呼吸與換氣空間(Breathing Room):歌曲轉換之間如果沒有預留過門,歌手根本無法換氣接唱。
「提出好題目,往往比給出答案更具決定性。」 將「多曲目混合」作為題目拋給 AI 工作流,徹底打破了「AI 只能做單首罐頭玩具」的成見,真正將符號樂理控制推到了極限。
面對現實瓶頸:為什麼「無法直接搭配人聲產出」?
在追求極致的過程中,我們不可避免地撞上了當前技術的硬邊界:AI 無法在多曲目混合場景下,直接端對端輸出完美契合本人聲線與情感的歌聲。
這並非工作流的失敗,而是極其寶貴的技術驗收證據:
- 消費級算力(8GB VRAM)的客觀極限:
YuE2 官方推薦環境是 24GB VRAM(如 RTX 4090 或 A10/A100)。在本機 RTX 4060(8GB 顯存)上,即便使用量化(Q4/Q8)或分段 CPU Offloading,處理 7 首歌長達近 3 分鐘的高規格符號樂譜,顯存與推論吞吐量皆已逼近紅線,難以支撐龐大的零樣本多曲人聲合成。
- DSP 轉調與聲音克隆的「金屬感恐怖谷」:
若嘗試透過現有音訊切片進行時間拉伸(Time-stretching)與音高修正(Pitch-shifting),或是套用聲音克隆(Voice Cloning)模型,演算法會無可避免地破壞人聲的共振峰(Formants),產生明顯的數位毛刺與「機器人塑膠金屬感」。
- 機器無法計算「爸爸的真實呼吸」:
更重要的是情感維度。一位父親在深夜三點抱著女兒哄睡時,那種極其輕柔、微弱、帶著愛意與一絲疲倦的真實氣息,是任何統計模型無法靠 Prompt 生成的。強行用 AI 人聲,只會讓原本溫馨的生活記錄變成冰冷的技術展示。
工作流的漂亮轉向:完整純伴奏 + 極致 KYV 練唱體系
當意識到「硬逼 AI 出人聲只會得到金屬感複製品」之後,這套工作流展現了極高水準的工程轉折:
「既然 AI 人聲沒有靈魂,那就讓 AI 成為地表最強的編曲樂隊與伴奏製作人;把最真誠的聲音,留給父親自己親自唱!」
工作流迅速收斂並產出了令人驚豔的「完整純伴奏自主錄唱專包」:
1. 廣播母帶級純伴奏體系
- 無損高規格音訊:輸出 48kHz 24-bit 廣播母帶級無損伴奏(
01_每一首都是妳_全曲完整純伴奏_48k24.wav)與 320k MP3,樂器分離度極佳,低頻溫暖、中頻飽滿; - 專屬設計的「過門換氣空間」:在 7 首歌交界處,工作流精確計算並保留了 2.0 ~ 3.0 秒的純伴奏過門。吉他或鋼琴自然流動,為歌唱者留出從容深呼吸的空間,徹底解決了搶拍與突兀轉場;
- 分段單曲練習伴奏:貼心將 7 首歌拆解為獨立的單曲練習伴奏(
03_分段單曲伴奏/),降低歌唱者一次錄完整首的心理負擔,隨時可以一段一段錄製。
2. 極致的 KYV (Karaoke Video) 逐字練唱生態
伴奏完成後,工作流並沒有只丟出一個音檔,而是構建了一套甚至超越商用 KTV 的逐字練唱系統:
outputs/每一首都是妳_完整純伴奏_自主錄唱專包_PRIVATE/
├── 01_每一首都是妳_全曲完整純伴奏_48k24.wav  (母帶伴奏)
├── 01_每一首都是妳_全曲完整純伴奏_320k.mp3   (跟唱推薦)
├── 02_每一首都是妳_前兩首短版伴奏_唯一到BabySong... (暖身短版)
├── 03_分段單曲伴奏/                          (7 首單曲獨立伴奏)
├── V24_逐字練唱全曲.mp4                      (KYV 變色字幕影片)
├── 打開逐字練唱.html                        (互動式網頁練習器)
└── README_全曲純伴奏與錄唱指南.md (完整時間戳與技巧手冊)- 互動式網頁練唱工具([打開逐字練唱.html](file:///A:/AI_Workspace/FamilyBridge/music/two-months-of-us/outputs/每一首都是妳_完整純伴奏_自主錄唱專包_PRIVATE/打開逐字練唱.html)):
- 雙擊瀏覽器即可離線開啟;
- 基於 MMS_FA 聲學對齊,歌詞隨音樂播放即時進行漸層發光(黃色高亮),精確提示起音點;
- 支援「單句循環播放」,哪一句咬字不順就反覆練哪一句;
- 提供「80% / 90% 降速慢練」,讓初學者有充裕時間熟悉轉音與節奏。
- 全曲 KTV 動態字幕影片([V24_逐字練唱全曲.mp4](file:///A:/AI_Workspace/FamilyBridge/music/two-months-of-us/outputs/每一首都是妳_完整純伴奏_自主錄唱專包_PRIVATE/V24_逐字練唱全曲.mp4)):
- 毫秒級精度的動態變色字幕,讓創作者在家看著螢幕就像置身頂級包廂,視覺與聽覺完全同步。
- 7 首 39 句精準進唱與呼吸時間表:
- 詳列每一句的時間戳記(例如〈唯一〉於
00:02.55s入句、〈Baby Song〉於00:16.50s進唱),並標明「聽吉他下拍進」、「深呼吸換氣」等專業指示。
爸爸的個人自主錄唱實戰手冊:把 AI 變成你的隨身製作人
有了這套伴奏與 KYV 工具,我親自嘗試了戴耳機跟唱與錄製。這段經驗讓我深刻體會到:真正的 AI 賦能,不是讓 AI 取代你的存在,而是讓 AI 替你把前置障礙全部拆除,讓你能夠心無旁騖地展現最真實的情感。
以下是我在實戰中總結的 4 大錄音避坑法則:
1. 戴耳機聽伴奏,手機只錄純人聲(乾聲)
- 關鍵忌諱:千萬不要用喇叭播放伴奏同時開手機錄音!這會導致伴奏聲音被二次收錄進麥克風,產生嚴重的空間殘響、相位抵消與回授雜音,後製完全無法分離。
- 正確做法:電腦或平板插耳機放伴奏(聽節奏與音準),手機打開「語音備忘錄 / 錄音機」放在面前約 15~20 公分處,平視微仰錄製乾淨的乾聲(Dry Vocal)。
2. 用最舒服的說話音高唱,不盲目飆高音
- 這首歌是唱給小朵聽的,不是參加歌唱選秀。
- 伴奏已經具備完整的和弦厚度與支撐力。爸爸唱歌時不需要刻意壓低嗓子裝深沉,更不需要硬飆原唱高音;像在床邊對女兒說話那樣溫柔、放鬆、真誠地唱,才是最打動家人的聲音。
3. 抓穩伴奏重拍(Downbeat),消除緊張搶拍
- 初次錄音最容易犯的錯誤就是「搶拍」——生怕進慢了而急著開口。
- 解決方法是「學會聽伴奏的腳步」:在耳機裡仔細捕捉木吉他掃弦的第一下、或是鋼琴低音落下的那個重拍點。每一句唱完後,不用慌張,留出半拍讓伴奏的泛音自然飄散。
4. 過門記得「深呼吸」
- 工作流在每首歌轉場特別保留了 2~3 秒的純樂器過門。
- 這不是死寂的空白,而是音樂的「呼吸窗口」。唱完上一首最後一個字後,放鬆肩膀,用這 2 秒深深吸一口氣,心理沉澱一下,再從容切換到下一首的心境。
5. 錄好乾聲後的後製閉環
錄完乾聲後,不必追求一鏡到底無瑕疵。只需將手機錄得的音檔交給後製工作流:
- 輕度底噪濾除:消除室內冷氣或環境底噪,保留聲音溫暖的高頻空氣感;
- 微幅節拍對齊:針對稍微晃動的字位進行無感對位;
- 廣播級動態混音:讓人聲與 48kHz 純伴奏完美貼合,完成專屬於家庭的永久紀念母帶。
算力帳本與部署現實:理性評估你的硬體邊界
回過頭來看整個工作流的技術基礎,如果你也想搭建類似的系統,硬體帳本依然需要算得一清二楚:
| 部署環境 | 顯示卡記憶體 (VRAM) | 適用任務與表現 | 妥協代價 |
|---|---|---|---|
| 官方標準基準 | 24 GB+ (RTX 3090/4090, A10) | 完整 3B 模型、48kHz 高取樣、單曲生成約數分鐘 | 硬體成本極高,需獨立 Linux 環境 |
| 消費級主流 (本機) | 8 GB ~ 12 GB (RTX 4060 / 3060) | 適合提取樂譜、符號編修、純伴奏工程與 KYV 對齊 | 需採用量化/分段卸載,端對端長組曲生成易 OOM |
| 環境依賴隔離 | 雙獨立 Python 環境 | SheetSage2 (PyTorch 早期版本) 與 YuE2 分開執行 | 無法同時併行,需先轉譜、釋放顯存再跑推論 |
對於一般創作者,我的建議是:不要試圖在消費級顯卡上硬跑端對端全曲人聲合成。善用開源工具進行符號提取、樂理校正與伴奏重構,結合本機成熟的聲學對齊工具(如 MMS_FA),產出純伴奏與練唱工具,才是投產比最高、成品最驚艷的落地路線。
結語:AI 負責鋪平道路,人類負責注入靈魂
這次的《每一首都是妳》組曲實踐,為我帶來了遠超預期的啟發:
- 題目決定高度:多曲目混合的命題,證明了音樂生成不再只是黑盒抽卡,而是具有深度的符號敘事架構;
- 技術承前啟後:從《凌晨三點的我們》的黑盒摸索,到《每一首都是妳》的白盒控譜,展示了一條從「玩具式抽卡」走向「專業協作」的真實路徑;
- 體驗重於炫技:48kHz 母帶伴奏、
打開逐字練唱.html與 YouTube KYV 影片,把複雜的 AI 程式碼轉化成了任何人在家都能輕鬆跟唱的溫暖工具。
AI 音樂的終點,從來不是用冰冷的演算法去冒充或取代人類的聲音;而是用強大的運算能力為我們搭好舞台、調好燈光、備好樂隊,然後溫柔地對我們說:
「伴奏已經準備好了,深吸一口氣,現在換你唱給最愛的人聽了。」